第零部|基礎知識 · 第 0 章
模型、Token 與 Context
建立 Agent 工程的共同語言:模型如何產生輸出,以及 token、message、context、tool、session 與 memory 分別是什麼。
一句話掌握本章核心:在討論 Agent 之前,必須先釐清「模型實際收到什麼」。本章依序拆解 Token、Message、Context、Context Window、Tool Call、Session 與 Memory。讀完後,你將能清楚指出每一次 API 呼叫中,每一份資料究竟儲存在模型權重、應用程式記憶體,還是硬碟之中。
先建立清晰的系統心智模型
在固定模型權重與推論設定下,可將大型語言模型(Large Language Model,LLM)視為一個不自行保存應用程式對話狀態的推論函式:輸入 Token 序列,計算下一個 Token 的條件機率分佈。這是設計 Runtime 時最純粹的工程抽象。實際取樣回覆可能略有不同,而部分 Provider API 也能在伺服器端保存或串接對話狀態。
產品中看似會流暢聊天、能讀寫專案檔案、能執行命令列的「AI」,本質上並非模型本身具備作業系統特權,而是外層的 Host Application 將模型、資料結構與系統呼叫(System Call)串接整合的成果。
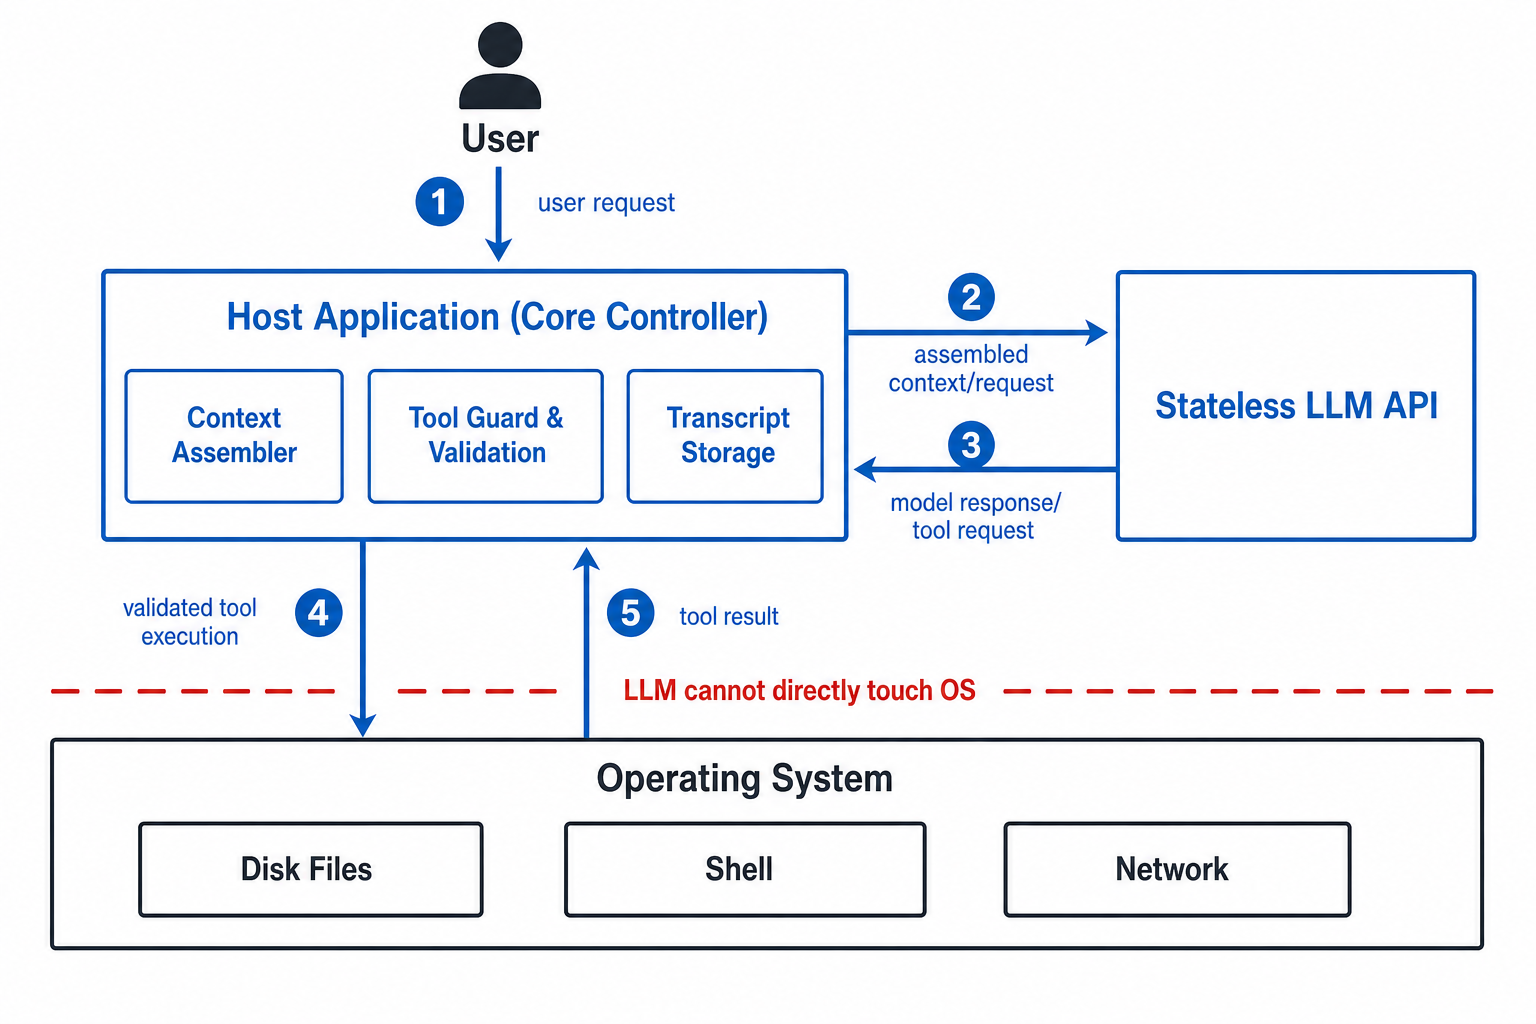
使用者 (User)
  ↓
Host Application
  ├─ 組合 Instructions、歷史對話、檢索資料與 Tool Definitions
  ├─ 呼叫 Model API(送出 Active Context)
  ├─ 驗證並執行 Model 請求的 Tool(發動 System Effects,如檔案讀寫或 Shell 執行)
  └─ 保存 Transcript / Session(持久化狀態到硬碟)
  ↓
Model:根據本次有效 Context 計算下一個回覆或 Tool Call 提議
對 tiny-agent 目前使用的 OpenRouter Chat Completions 配接器(Adapter)而言,模型可用的資料完全來自本次 Request 中的 Messages、Tool Definitions 與其他明確輸入。未送入的檔案系統、資料庫或環境變數,絕對不會憑空出現在 Context 中。這不是所有 API 的通則:例如 OpenAI Responses API 可用 previous_response_id 串接由 Provider 伺服器端管理的對話狀態,詳見 OpenAI Conversation State。
推薦觀看:建立 LLM 的直觀理解
在深入探討 Token、Context 與推論生命週期前,推薦先觀看 3Blue1Brown 的視覺化解析。它能幫助你在腦中建立神經網路計算的具體直覺,之後再閱讀本章的工程定義時,更容易將「模型本身」與「外層 Agent 系統」清晰拆分。
Token:計算與計費的基本單位
TL;DR:模型不認識「字元」或「單字」,它處理的是經過 Tokenizer 切割後的整數識別碼(Token ID)。
原始文字字串 → [ Tokenizer ] → Token IDs [15496, 11, 703] → [ Model ] → Output Token IDs → [ Decoder ] → 輸出文字字串- 英文單字:常見單字通常是一個 Token(如
apple),罕見字或複合詞會被拆解為多個 Subwords。 - 中文字詞:不保證「一字一 Token」。實際切分與數量取決於模型使用的 Tokenizer。
- 非文字資料:程式碼縮排、JSON 標點符號、大型 Log 與 Base64 字串通常也會占用可觀 Token,程度仍依 Tokenizer 與資料內容而定。
- 資源限制:Token 數量會影響 Context Window 用量、傳輸與推論延遲、以及依 Token 計費的 API 成本。排隊、模型、硬體與快取也會影響延遲。
模型如何產生答案
TL;DR:模型輸出是「逐字機率預測」,不是「資料庫查詢」。
模型每一步都根據目前已有的所有 Tokens(Prefix),計算下一個 Token 的條件機率分佈 P(token | previous tokens),再由 Decoding Policy 取樣選出一個 Token,寫入序列後重複此迴圈,直到觸發停止符號(Stop Sequence)或達到最大長度上限。
| 核心現象 | 計算機科學成因 | 軟體工程對策 |
|---|---|---|
| 可能產生幻覺 (Hallucination) | 模型追求機率分佈上的語意連貫,非事實查證 | 關鍵資訊必須依賴 Tool 讀取真實資料驗證 |
| 上下文順序敏感 (Order Matters) | 自注意力機制(Self-Attention)受位置編碼強烈影響 | 關鍵 Instructions 與 Guardrails 應放置於顯著位置 |
| 輸出具隨機性 (Non-deterministic) | Temperature 取樣機制與分散式浮點數運算微小誤差 | 測試應驗證「資料契約 (Contract)」而非比對字串逐字相符 |
Prompt、Message 與 Transcript
現代 LLM API(如 OpenAI, Anthropic)多採用具有「結構化角色」的 Message 陣列作為標準輸入:
| 角色 (Role) | 用途與語意 | 資料來源與信任等級 |
|---|---|---|
system / developer | 設定 Agent 核心身分、行為規範、工具使用守則 | 受信任的 Host Application |
user | 使用者輸入的指令、問題或外部事件 | 外部使用者(不受信任輸入) |
assistant | 模型先前的推論回應或發起的 Tool Call 請求 | LLM 生成輸出(待驗證) |
tool | 對應 Tool Call 執行後的觀測結果或錯誤文字 | Host Tool Adapter 產生。內容仍可能來自不受信任的檔案、行程或遠端服務 |
三者名詞釐清:
- Prompt:指送入模型的所有輸入集合(包含 Instructions、對話歷史與 Tool 定義)。
- Transcript:在記憶體或硬碟中,依照嚴格時序 append-only 累積的 Message 歷史陣列。
- Role Invariant:Host 必須維持 Message 序列合法。例如:Assistant 一輪發出的每個 Tool Call,都必須有相同
tool_call_id的 Tool Result。完成這組 Calls 前不可插入無關的新對話。
Context 到底是什麼
Context 是模型在單次推論當下,暫存於其計算視窗中的「全部有效輸入集合」。
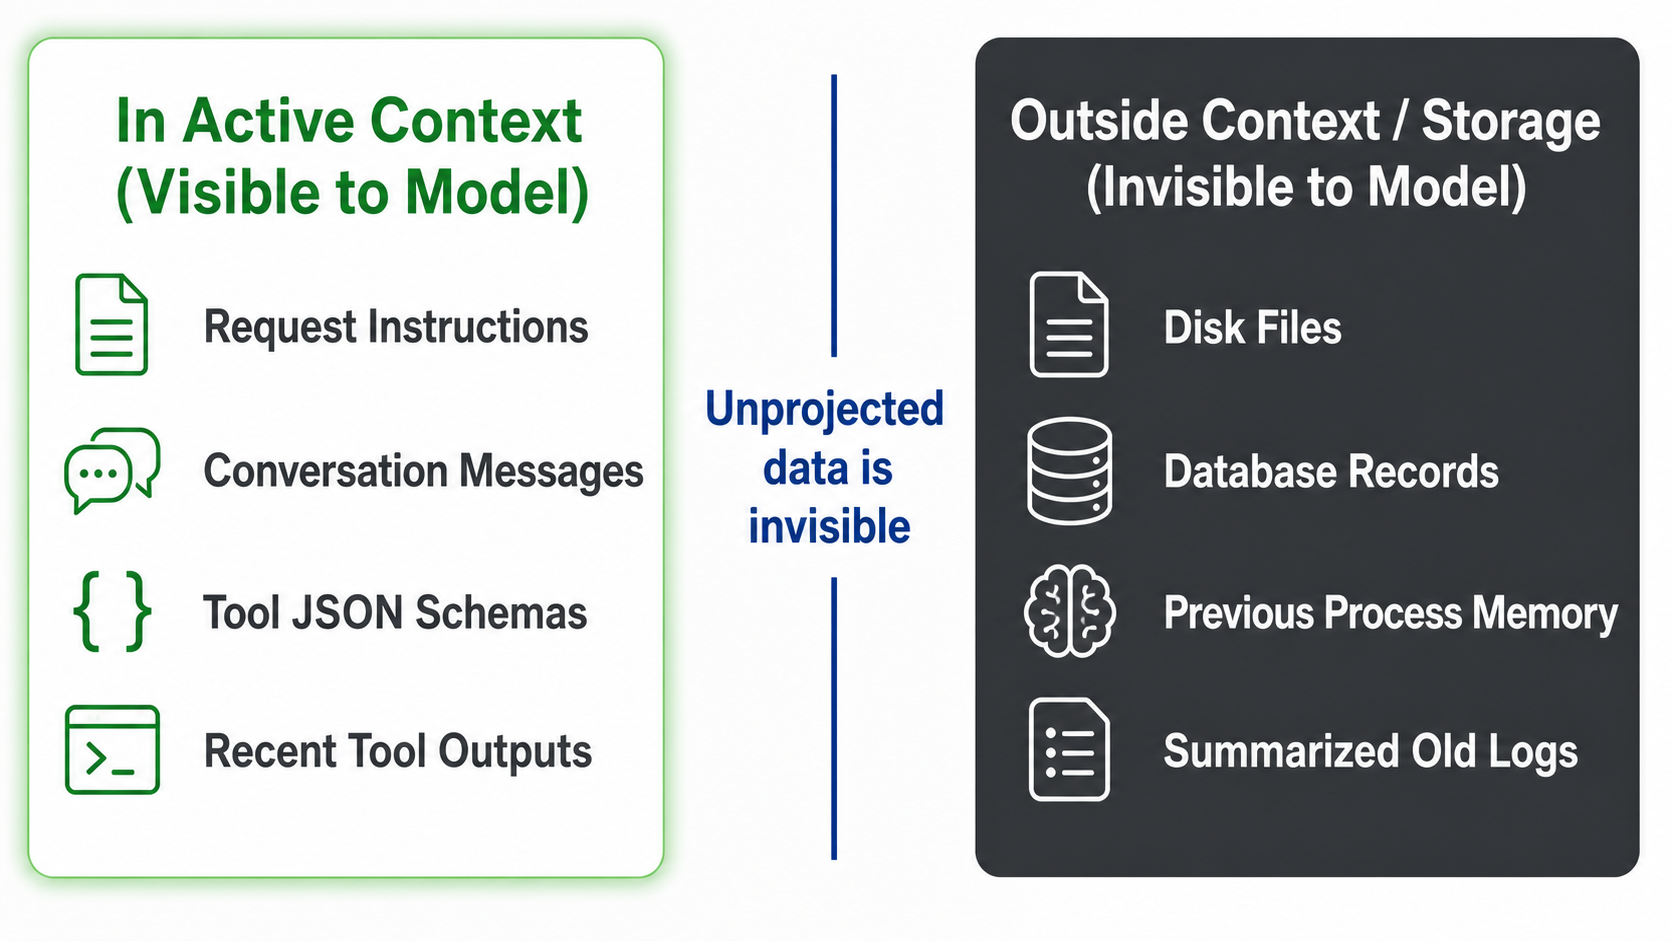
在 Active Context 裡(模型看得見)
- 本次 Request 明確送入的 System Prompt
- 目前選入對話歷史中的 Messages
- 本次提供給模型的 Tool JSON Schemas
- 剛由 Host 執行並寫回的 Tool Result
不在 Active Context 裡(模型完全看不見)
- 本機硬碟中存在但尚未被
read的檔案 - 資料庫中存在但尚未被查詢的記錄
- 上一個已結束 Process 的記憶體狀態
- 被 Compaction(歷史壓縮)移出視窗的原始對話
Context Window 與 Token Budget
Context Window 是模型單次 Request 能處理的 Token 上限。OpenAI 與 Anthropic 的官方文件均說明,輸入、輸出,以及適用時的 Reasoning Tokens、Tool Definitions 與 Tool Results 都可能計入此上限。其分配可簡化為以下約束:
System Instructions + Conversation Messages + Tool Definitions + Retrieved Docs + Max Output Tokens ≤ Context Window Limit在系統工程中,並非「Context 越大塞越多越好」。超過上限會引發截斷錯誤。而在上限內塞入過多雜訊則會導致注意力稀釋(Needle In A Haystack 效應),使模型遺漏核心規則。
| Context 管理手法 | 工程目標 | 具體作法 |
|---|---|---|
| Selection(精準篩選) | 降低雜訊,提升注意力集中度 | 只注入與當前任務高度相關的指令與檔案片段 |
| Progressive Loading(漸進載入) | 節省初始 Token,按需付費 | 啟動時僅載入 Skill 名稱,被觸發時才載入詳細文件 |
| Compaction(上下文壓縮) | 突破長對話 Window 限制 | 將舊對話摘要為結構化 Facts,移除非關鍵中間過程 |
| Bounding(輸出邊界保護) | 防止單一 Tool 撐爆 Window | 截斷過長的 Bash 輸出與巨大檔案內容 |
Tool Call:模型提議,Host 執行
重要原則:Tool Call 是結構化的工具呼叫提議。只有在 Provider 與模型支援且啟用 Strict Mode 時,才可期待參數可靠遵循 Schema。tiny-agent 目前的 Chat Completions Tool Definitions 未啟用 strict: true,因此 Host 仍須解析並驗證所有參數。模型沒有直接取得作業系統執行權限,真正的副作用由 Host 發動。參見 OpenAI Function Calling:Strict Mode。
1. Host 送入定義  ───→  提供 read(path: string) 的 JSON Schema
                             ↓
2. Model 發起提議  ───→  回傳結構化 JSON:{ name: "read", arguments: { path: "main.go" } }
                             ↓
3. Host 驗證派發  ───→  檢查 Plugin Allowlist、參數為 JSON Object 與 Built-in 欄位型別
                             ↓
4. Host 發動 Effect ──→  呼叫 OS System Call 讀取檔案
                             ↓
5. Host 寫回結果  ───→  以 role: "tool" 訊息將檔案內容 Append 回 Transcript
                             ↓
6. Model 下次可見 ───→ 模型在下一個 Request 才能根據內容進行推理狀態解構:Model、Session 與 Memory
在資工系統設計中,切忌將所有儲存抽象籠統稱為「記憶」。必須嚴格區分每一種狀態的儲存媒介與生命週期:
| 概念名詞 | 本質定義 | 儲存媒介 | 生命週期 (Lifecycle) |
|---|---|---|---|
| Model Weights | 神經網路訓練權重 | GPU VRAM / Provider 伺服器 | 長久固定,推論時不改變 |
| Active Context | 當前單次推論可引用的 Token 集合 | Inference Runtime。Provider 可能另有不受應用程式控制的快取或對話狀態 | 應用程式不可假設下次 Request 能直接取用,須依 Endpoint 的狀態契約 |
| In-memory Transcript View | Runtime 當下使用的結構化 Message 串列 | Host Process Heap Memory | Process 結束即消失,但可由 Durable Session 重建 |
| Durable Session | 支援 Crash Recovery 的交易記錄 | 本機磁碟(JSONL WAL 檔案) | 持久儲存,支援跨 Process 復原 |
| Memory Service | 跨任務的長期事實或偏好索引 | 例如關聯式、文件、向量或 Key-Value Store,也可由檔案或 Provider Service 實作 | 依產品政策跨 Session 或專案保存 |
六個常見的觀念誤解 (Pitfalls)
| 常見錯誤直覺 | 系統工程真實情況 |
|---|---|
| ❌ 「模型知道專案裡的所有檔案」 | ✅ 模型只知道本次 Request 送進去的檔案,其餘必須透過 Tool 讀取。 |
| ❌ 「UI 畫面上看得到的訊息,模型都看得到」 | ✅ UI 呈現的是歷史儲存,送入模型前可能已經過裁切、篩選或摘要。 |
| ❌ 「有了 JSON Schema 就能保證安全」 | ✅ Schema 或 Strict Mode 只處理結構契約。權限、路徑、Shell 與網路政策必須由 Host / Deployment Guard 負責。tiny-agent 目前不做 CWD Containment。 |
| ❌ 「Prompt Caching 能擴大 Context 容量」 | ✅ 快取只降低重複 Prefix 的運算時間與計費,無法突破 Context Window 物理上限。 |
| ❌ 「模型說它已經修改好檔案,代表檔案已修改」 | ✅ 應核對 Host 實際派發的 Tool、目標路徑、執行結果與後續讀取或測試。Tool Result 比模型自述更可稽核,但不是單獨且充分的真實性證明。 |
| ❌ 「Process 崩潰重啟後,可以直接重放所有動作」 | ✅ 外部副作用(如寫檔、發 API)狀態未知,未經安全檢查重放會引發嚴重重複副作用。 |
自我檢查 (Review Questions)
- 硬碟中存在但未被 Tool 讀取的檔案,是否存在於模型的 Active Context 中?
- Provider 的 Prompt Cache 命中時,會不會釋放 Context Window 的可用容量?
- Tool Call 回傳的 arguments 參數,在 Host 端可以直接信任並執行嗎?為什麼?
- Transcript、Active Context 與 Durable Session 這三者在生命週期上有何本質區別?
- 當模型輸出「測試已全數通過」時,Host 端應依據什麼證據確認真實性?
釐清了基礎概念後,我們知道:在本專案的工程抽象中,Model 負責推論。Host 掌控 Transcript、執行 Tool 並產生副作用。Session 負責持久化狀態。下一章會以教學用的 Canonical Agent Loop 串起這些角色。