第二部|能力邊界 · 第 4 章
Context、AGENTS.md 與 Skills
把專案規則與領域知識放入正確層級,使用 progressive loading 控制 context 成本。
一句話掌握本章核心:Context Engineering 不是「把所有資料都塞給模型」,而是建立結構化分層(Layering)與漸進式載入(Progressive Loading)機制:讓通用規則常駐、專案規範明確隔離、領域知識(Skills)僅在命中時動態載入。
Context 的四種組裝來源
在組裝每次 API Request 時,可把 tiny-agent 的輸入理解為四種來源。這是 Host 端的組裝模型,不是 provider 協定原生的四級權限:Project Rules 與 Skill Metadata 實際上都被串進同一則 system message,Conversation 則是後續 transcript。
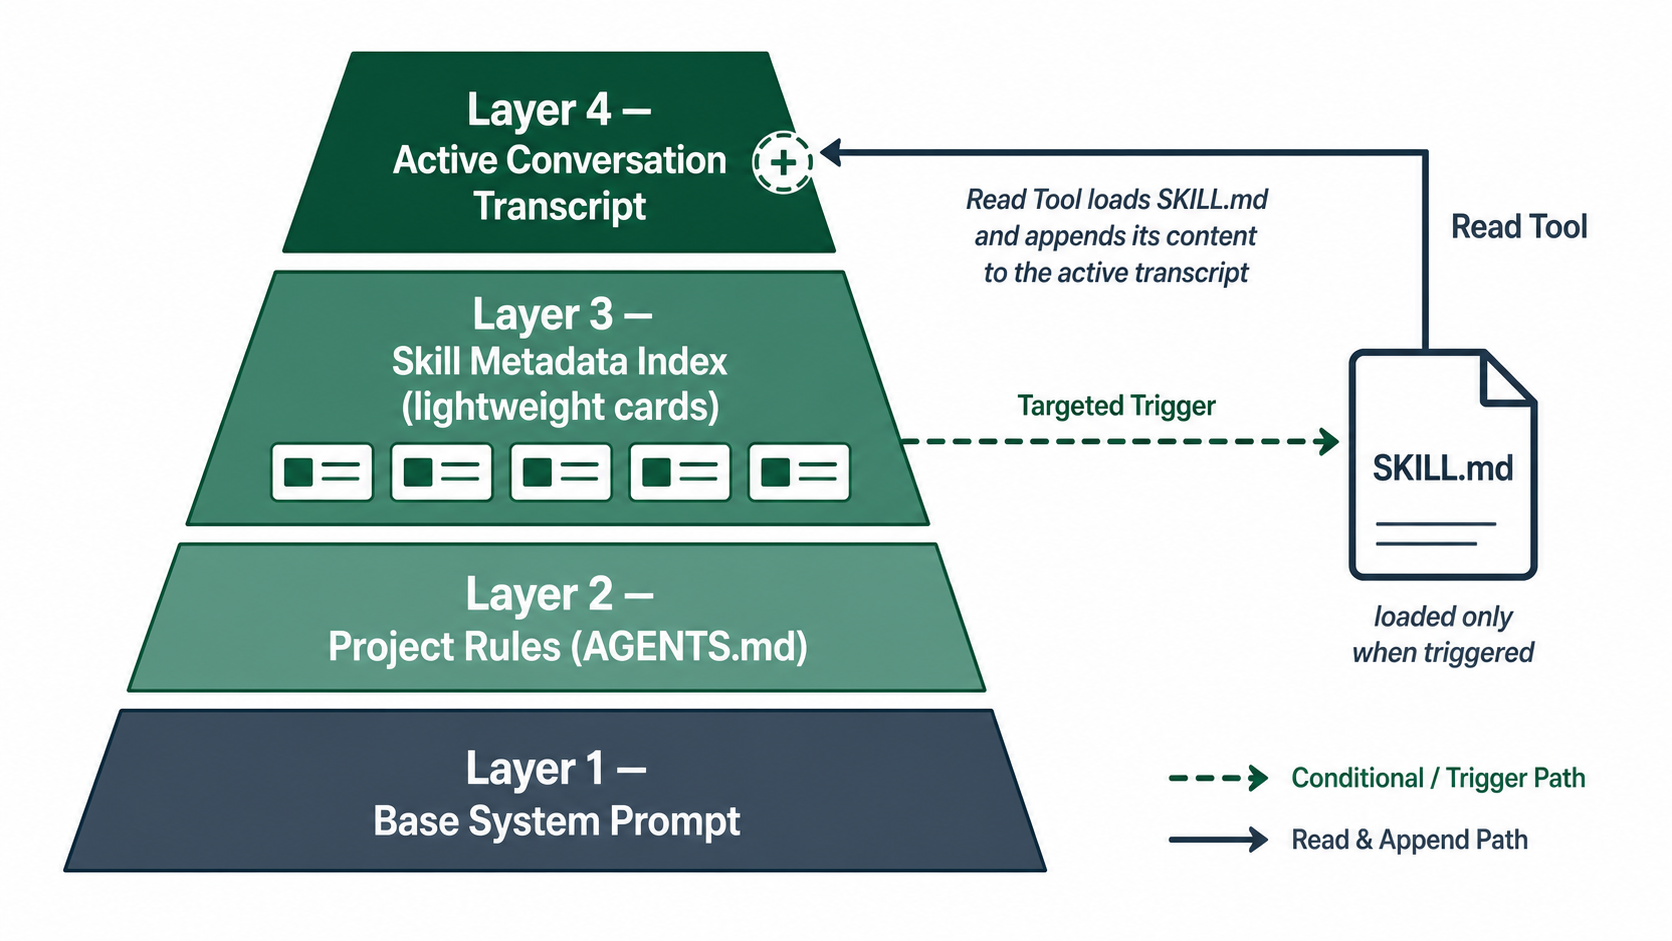
| Context 層級 | 資料來源 | 生命週期與特性 | Token 佔用成本 |
|---|---|---|---|
| 1. Base Instructions | 內建 Runtime | 核心 Agent 身分、基本 Workflow 準則。組入 system message | 固定文字,但 token 數依 tokenizer/model 而異 |
| 2. Project Rules | ./AGENTS.md | 目前專案特定的 Coding Style、禁忌與指令。同樣組入 system message | 隨檔案長度增加。穩定 prefix 可能符合 Prompt Cache 條件 |
| 3. Skill Metadata | .tiny-agent/skills/**/SKILL.md 與 --skill | 索引只放 Name、Description 與 Location,不預載正文 | 仍會隨 skill 數量、描述與路徑長度線性增加,但通常遠小於全文 |
| 4. Conversation | 即時對話歷程 | 動態 Append 的 User 指令、Tool Calls 與 Observations | 持續成長(需透過 Compaction 治理) |
AGENTS.md:專案規則的結構化隔離
專案規則不應隨意散落在 System Prompt 之中。tiny-agent 啟動時讀取工作目錄下的 ./AGENTS.md,並將其包裝在具備語意邊界的 XML 標籤內:
<project_context>
Project-specific instructions and guidelines:
<project_instructions path="/workspace/AGENTS.md">
- 遵循 LBYL 原則,禁止無意義 try/catch
- 檔案工具使用 4 空格縮排
- 測試覆蓋率必須維持 100%
</project_instructions>
</project_context>Skills 的漸進式載入 (Progressive Loading)
核心設計哲學:不要在啟動時把所有 Skill 的正文全數灌入!
系統啟動時遞迴掃描目錄,以小型 parser 從 frontmatter 抽取單行 name 與 description,再加上檔案 location 建立輕量索引。它不是完整 YAML parser。多行 scalar、巢狀結構等一般 YAML 語法不在此教學實作的 contract 內:
---
name: i-have-adhd
description: 針對 ADHD 讀者最佳化輸出結構,提供結論先行、高對比度表格與精簡清單。
---| 比較項目 | 全部預先載入 (Eager All-in) | 漸進式按需載入 (Progressive Loading) |
|---|---|---|
| 初始 Token 消耗 | 隨 Skill 全文總長線性增加 | 也會隨 metadata 數量線性增加,但斜率通常較低。應以目標 model tokenizer 實測 |
| 模型注意力聚焦 | ❌ 充斥大量無關領域規則,干擾推論 | ✅ 保持上下文純淨,模型只關注當前任務 |
| 可稽核性 (Auditability) | 正文從 request 一開始就存在,較難分辨何時真正使用 | Autonomous route 若呼叫 read(SKILL.md),該 tool call/result 會進 durable Session。這能證明曾讀取,不證明模型確實遵循或正確理解 |
兩種合法的 Skill 載入路徑
- 模型自主觸發(Autonomous Route):
模型閱讀 Metadata 後,判斷當前任務匹配該 Skill,主動呼叫read(path: ".tiny-agent/skills/.../SKILL.md")。System prompt 要求缺少能力時說明限制,而 runtime 能保證的是「未提供的 tool 不會被派發」。它無法保證模型一定誠實、一定選中正確 Skill 或一定產生特定措辭。 - 使用者顯式指定(CLI Slash Command Route):
使用者輸入/skill:i-have-adhd 說明架構。CLI 作為 Trusted Host 會直接讀取本機 Skill 檔案,將全文附加至本次 User Message 送入,此路徑完全不需要賦予模型read權限。
Context 膨脹與治理防線
在多輪對話中,每一次 Tool 的執行結果(尤其是大型 Log 或檔案讀取)都會使 Transcript 迅速膨脹:
Round 1: [System] + [User] ───────────────→  500 Tokens
Round 2: ... + [Assistant] + [Tool: read] ─→ 4,500 Tokens
Round 3: ... + [Tool: bash test] ─────────→ 12,000 Tokens (持續累積...)
即使 Provider 支援 Prompt Cache 降低費用,Context Window 的物理上限依然存在。完整的 Context 治理必須包含:
- Tool 邊界截斷:單次
read最多 2,000 行 / 50KB。bash輸出限制長度。 - Skill 漸進載入:維持極小 Initial Context。
- Durable Compaction(歷史壓縮):適時將舊對話總結為精確 Facts(詳見第 7 章)。
深度解析:Frontmatter 小型解析器的邊界與設計取捨
tiny-agent 在讀取 SKILL.md 時,並未引入肥大的外部 YAML 解析套件,而是採用了一個幾十行的輕量解析器。這個設計取捨貫徹了「教學專案保持核心清晰」的原則,但也確立了嚴格的語法契約:
// tiny-agent 內建 Skill Frontmatter 解析契約
// 1. 僅辨識檔案最前端以 --- 包裹的標頭
// 2. 僅抽取單行鍵值對:name 與 description
// 3. 不支援巢狀結構、多行字串、錨點 (Anchors) 或複雜類型
function parseSkillMetadata(content: string): { name: string; description: string } | null {
    const match = content.match(/^---\r?\n([\s\S]*?)\r?\n---/);
    if (!match) return null;

    // 嚴格比對頂層的 name 與 description 欄位
    const nameMatch = match[1].match(/^name:\s*(.+)$/m);
    const descMatch = match[1].match(/^description:\s*(.+)$/m);
    if (!nameMatch || !descMatch) return null;

    return {
        name: nameMatch[1].trim(),
        description: descMatch[1].trim(),
    };
}
為什麼不用標準 YAML 套件?
在 Agent 的啟動流程中,可能需要掃描專案內數十個 Skills。引入完整的 YAML Parser 會帶來額外的相依性包袱,甚至引入潛在的 Prototype Pollution 或 ReDoS 安全風險。透過限制語法為極簡契約,系統在啟動階段只需花費數毫秒即可完成所有 Skill 中繼資料的抽取。
動手驗證 (Hands-on Lab)
本實驗將引導你動手打造一個專屬的自訂 Skill,並親自驗證 Agent 如何透過漸進式按需載入(Progressive Loading)來維持極簡的初始上下文:
實驗一:撰寫自訂 Skill 並觀察中繼資料索引
在當前目錄建立一個符合 tiny-agent 規範的 Skill 定義檔:
# 1. 建立技能目錄結構
mkdir -p .tiny-agent/skills/taiwan-locale

# 2. 撰寫 SKILL.md,包含 Frontmatter 標頭與具體操作指引
cat <<'EOF' > .tiny-agent/skills/taiwan-locale/SKILL.md
---
name: taiwan-locale
description: 協助校驗文字符合臺灣繁體資工習慣用語,例如呼叫、記憶體、行程。
---

# 臺灣資工詞彙校正指南
當使用者詢問用語時,請務必依據下列規範:
- 「調用」請轉換為「呼叫 (Call)」
- 「內存」請轉換為「記憶體 (Memory)」
- 「進程 / 線程」請轉換為「行程 (Process) / 執行緒 (Thread)」
EOF
實驗二:自主觸發載入 vs. 顯式指令載入
現在我們分別以兩種路徑觀察系統的行為差異:
# 路徑 A:模型自主觸發(需要 read 工具權限)
# 模型看見中繼資料後,主動呼叫 read 讀取 SKILL.md 全文
tiny-ts --plugin read "請確認這段程式碼中是否包含非臺灣用語:'這個函數會調用系統底層進程'"

# 路徑 B:Trusted Host 顯式載入(完全不需 read 工具)
# CLI 作為信任外殼,在啟動前直接將 SKILL.md 注入至 User Message
tiny-ts --plugin write "/skill:taiwan-locale 校驗這句話:'釋放未使用的內存'"實驗觀察重點:
- 在路徑 A 中,檢視
.tiny-agent/sessions/內的 JSONL 日誌,你會發現一筆具體的readTool Call 及其 Observation,這留下了完整的可稽核軌跡。 - 在路徑 B 中,模型在未被賦予
read權限的狀態下,依然成功獲得了領域知識。這證明了「Host 端 Trusted Seam」可以在不對模型放寬系統特權的前提下,靈活注入必要的情境。
至此,我們已經掌握了 Agent 的大腦(Model)、手腳(Tools)與注意力(Context)。實際 CLI 在開始工作前就會建立或開啟 JSONL Session,並在每一步追加 facts。記憶體中的 messages 只是可由 durable log 重建的 active view。下一章將把這條已存在的持久化路徑拆開,說明先記 Intent,再發動 Effect的寫入順序、torn-tail 修復與明確的 durability 限制。